2026-08-14
Mój setup developerski na sierpień 2026
Mój workflow z agentami AI według stanu na sierpień 2026: Hermes jako orkiestrator, OMP do implementacji i modele open-source za ułamek kosztów.
Wprowadzenie
Ten blog pierwotnie miał się nazywać “My coding setup”, ale po przemyśleniu sprawy zdecydowałem, że najlepiej będzie dodać mu znacznik czasu. Mój workflow nie ma nic wspólnego z tym, jak wyglądał w czerwcu 2026, kwietniu 2026 czy grudniu 2025.
Od początku roku moim głównym harnessem do wszystkiego jest OmO, działający na OpenCode.
Pod koniec maja coś się zmieniło.
Słyszałem i czytałem o Hermes Agent, ale nigdy tak naprawdę nie przetestowałem go porządnie. W końcu dałem mu szansę i okazało się, że to niesamowite odkrycie.
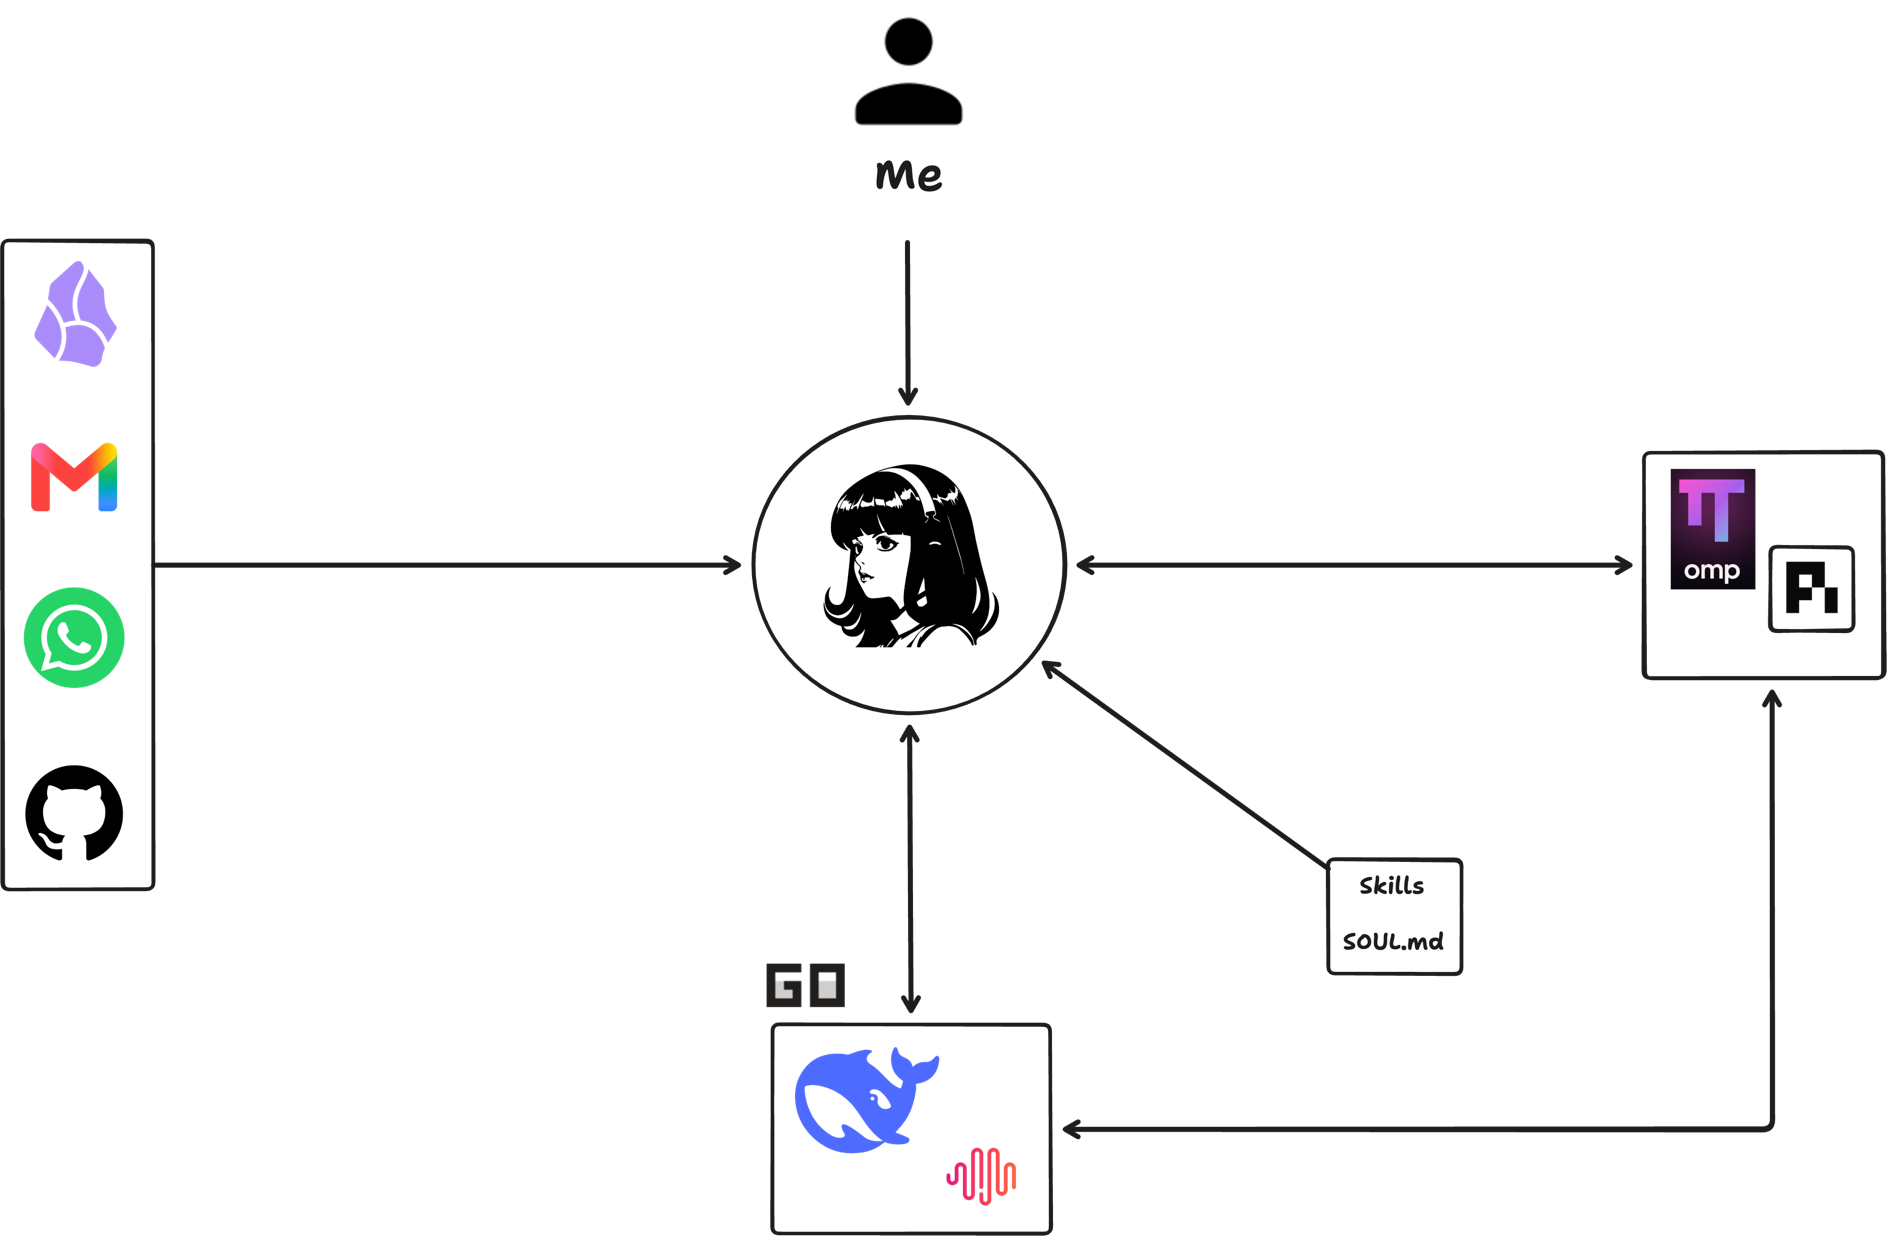
Zanim przejdę do szczegółów, dam szybki przegląd mojego stacku w tej chwili. Moje źródła informacji i baza wiedzy to: Obsidian, Gmail, WhatsApp i GitHub, od czasu do czasu pojawia się coś jeszcze, ale to są te główne. W Obsidianie trzymam wszystkie pliki markdown: SOP-y (Standard Operating Procedures), notatki ze spotkań, research, posty z X, narzędzia, artykuły i długie etcetera, co samo w sobie zasługuje na osobny post. Gmail i WhatsApp to komunikacja z klientami, a GitHub, często z GitHub Projects, organizuje rozwój, śledzi issue i feature’y oraz trzyma historię zmian.
Modele
Wszystko to jest podłączone do Hermesa (i do każdego dodatkowego narzędzia, którego akurat używam). Do niedawna moje sesje robocze z Hermesem korzystały zwykle z potężnego modelu — w tym miesiącu był to GPT 5.6 z thinking extra high — ale od premiery najnowszego DeepSeek V4 Flash zdałem sobie sprawę, że to model wystarczająco mocny, żeby autonomicznie prowadzić długohoryzontowe zadania kodowania, orkiestrować sesje implementacji, walidować, testować i wdrażać. Robi wszystko to, co osiągałem z GPT 5.6 w moim stacku, tylko około 80 razy taniej (!!!), co jest po prostu absurdalne. Od nieco ponad tygodnia używam więc modeli DeepSeek do wszystkiego, poza wizją — tam używam MiniMax M3, bo DeepSeek nie jest multimodalny. Na dziś, 14 sierpnia, kiedy to piszę, właśnie wyszedł GLM 5.3, model konkurujący bezpośrednio z Fable i GPT 5.6, znowu za ułamek kosztów, więc bez wątpienia włączę go do swojego workflow (prawdopodobnie razem z Kimi K3).
Poza samą inteligencją DeepSeek ma throughput (tokeny na sekundę) prawie 2 razy szybszy niż GPT 5.6, więc zauważyłem też poprawę szybkości zadań — zarówno orkiestracji, jak i implementacji.
I oczywiście, jak mówiłem, koszty są chyba najbardziej uderzającą rzeczą, skala oszczędności jest po prostu śmieszna. Nie używam jednak API modeli bezpośrednio — dla modeli open-source korzystam z planu Opencode Go, bardzo polecam, żeby w jednej subskrypcji mieć dostęp do wszystkich modeli open-source, hostowanych w USA, UE i Singapurze.
Orkiestrator
Z poziomu Hermesa cała ta baza wiedzy służy do analizowania tego, co leży na stole, projektowania architektury, planowania implementacji, strukturyzowania pracy, tworzenia ticketów, walidacji, researchu (zarówno we własnych źródłach, jak i w sieci) i jako ostatni krok — przygotowywania promptów, czy to dla kolejnej sesji orkiestrującej, czy dla sesji implementacyjnych.
To ostatnie jest ważne i to największa zmiana w moim workflow w ostatnich miesiącach: nie promptuję już agentów kodu. W ostatnich miesiącach pojawiło się mnóstwo “agent harnessów” i skilli (można by je nazwać strategiami promptowania), jak ultrawork, drill-me itd. Przychodzi moment, w którym wybór skilli i formy czy struktury promptowania zależny od człowieka staje się żmudny, powolny i mało precyzyjny, bo udana sesja wymaga promptu, który jest obszerny, jasny i dobrze domknięty.
Tu wkracza magia Hermes Agent. Po przejrzeniu źródeł informacji ma wystarczająco dużo kontekstu, żeby przedyskutować ze mną, które problemy atakować, w jakiej kolejności i z jakim priorytetem. Największa wartość mojego Hermes Agent to prawdopodobnie nie samo narzędzie (hermes), tylko skille, metodologie pracy i SOUL.md. Do zadań kodowych używam zawsze około 5 skilli, plus dodatkowe, których wymaga przypadek (frontend, Rust, testing), czyli od 5 do 10. W tych 5 głównych skillach zapisany jest podręcznik mojego sposobu pracy: jak orkiestrować, jak testować, jak robić QA i jak wykonywać inne zadania, które mogą się pojawić w trakcie sesji roboczej.
Te skille nie powstały z dnia na dzień. Przeszły długi proces iteracji i wciąż ewoluują z metodologiami takimi jak GEPA, chociaż — znowu — to temat na osobny artykuł.
Implementacja
Do niedawna Codex był moim głównym narzędziem implementacji, z modelami GPT 5.6 Sol i Luna, razem z pluginem zbudowanym na OmO o nazwie LazyCodex, który w zasadzie przenosi metodologię OmO do Codexa.
Jeśli chodzi o Claude Code — nigdy go nie używałem. Modele Anthropica zawsze odpalałem z opencode i OmO, aż do momentu, w którym Anthropic zakazał używania swojej subskrypcji kodowania w narzędziach firm trzecich.
Więc czego używam dziś? oh-my-pi (OMP), harnessa zbudowanego na Pi, który jest niesamowity: nie tylko zwiększa odsetek udanych zadań, ale robi to przy mniejszym zużyciu tokenów, a więc obniża koszty!
OMP ma też wiele ciekawych funkcji, które wyróżniają go na tle innych harnessów: tryb goal, LSP, subagenci, model doradczy obserwujący sesję, żeby zapobiegać zboczeniom, hashline, pamięć i wiele więcej.
Te sesje OMP są odpalane przez Hermesa (w trybie headless) w tak zwanych lane’ach, czyli falach pracy, w których równolegle leci kilka sesji, co mocno przyspiesza tempo implementacji. Używam też narzędzi takich jak codegraph, które jeszcze bardziej redukują zużycie tokenów i zwiększają odsetek sukcesów.
Mimo to, patrząc na niedawno opublikowany deepseek harness, na pewno przetestuję go w nadchodzących dniach.
Podsumowanie
Trudno nadać temu systemowi konkretną nazwę. W czerwcu ludzie zaczęli nazywać to “Loop Engineering”, ale wydaje się, że to określenie wychodzi z użycia albo robi się niejednoznaczne; inni po prostu nazwaliby to harnessem. Ostatecznie etykieta nie ma znaczenia. To świat, który zmienia się i ewoluuje tak szybko (dosłownie z tygodnia na tydzień), że etykiety nie nadążają.
Żaden workflow nie jest doskonały, zawsze jest miejsce na poprawki i błędy, cały czas identyfikuję rzeczy do zmiany, to system w ciągłej ewolucji i postępie.
Do tego dochodzi nowy trend, który zyskał popularność w ostatnich miesiącach: agenty self-improving. Część popularności Hermesa, zwłaszcza na początku, wynika z tego, że potrafi sam aktualizować swoje skille. To świetne, ale czasami ani to, ani pamięć nie wystarczają. Tu wkraczają metodologie takie jak GEPA i paradygmaty takie jak Recursive Language Models (RLM) — coś bardzo innowacyjnego, o czym na pewno będziemy słyszeć coraz więcej w nadchodzących miesiącach.
Zakończenie
Za kilka miesięcy (albo tygodni, kto wie) pewnie wrócę do tego tematu, ekscytuje mnie myśl o tym, jak bardzo zmieni się mój workflow do tego czasu. Niektóre rzeczy da się przewidzieć, wiele innych jest kompletnie nieoczekiwanych.
Na koniec dnia w tym świecie liczy się bycie na bieżąco, nie bać się próbować nowych rzeczy, a przede wszystkim nie wiązać się z żadnym narzędziem i nie bać się go zostawić, jeśli trzeba.