2026-08-14
Mi setup de desarrollo a agosto de 2026
Mi flujo de trabajo con agentes de IA a agosto de 2026: Hermes como orquestador, OMP para implementar y modelos open-source por una fracción del coste.
La introducción
En un principio este blog se iba a llamar “My coding setup”, pero tras pensarlo, finalmente he decidido que lo mejor es ponerle una marca temporal. Esto se debe a que mi flujo de trabajo no tiene nada que ver con lo que era en junio de 2026, abril de 2026, o diciembre de 2025.
Desde principios de este año, empecé a usar como mi harness principal OmO para todo, desde Opencode.
A finales de mayo algo cambió.
Había escuchado y leído sobre el Hermes Agent, pero realmente no lo había probado bien. Finalmente, decidí darle una oportunidad y resultó ser un descubrimiento increíble.
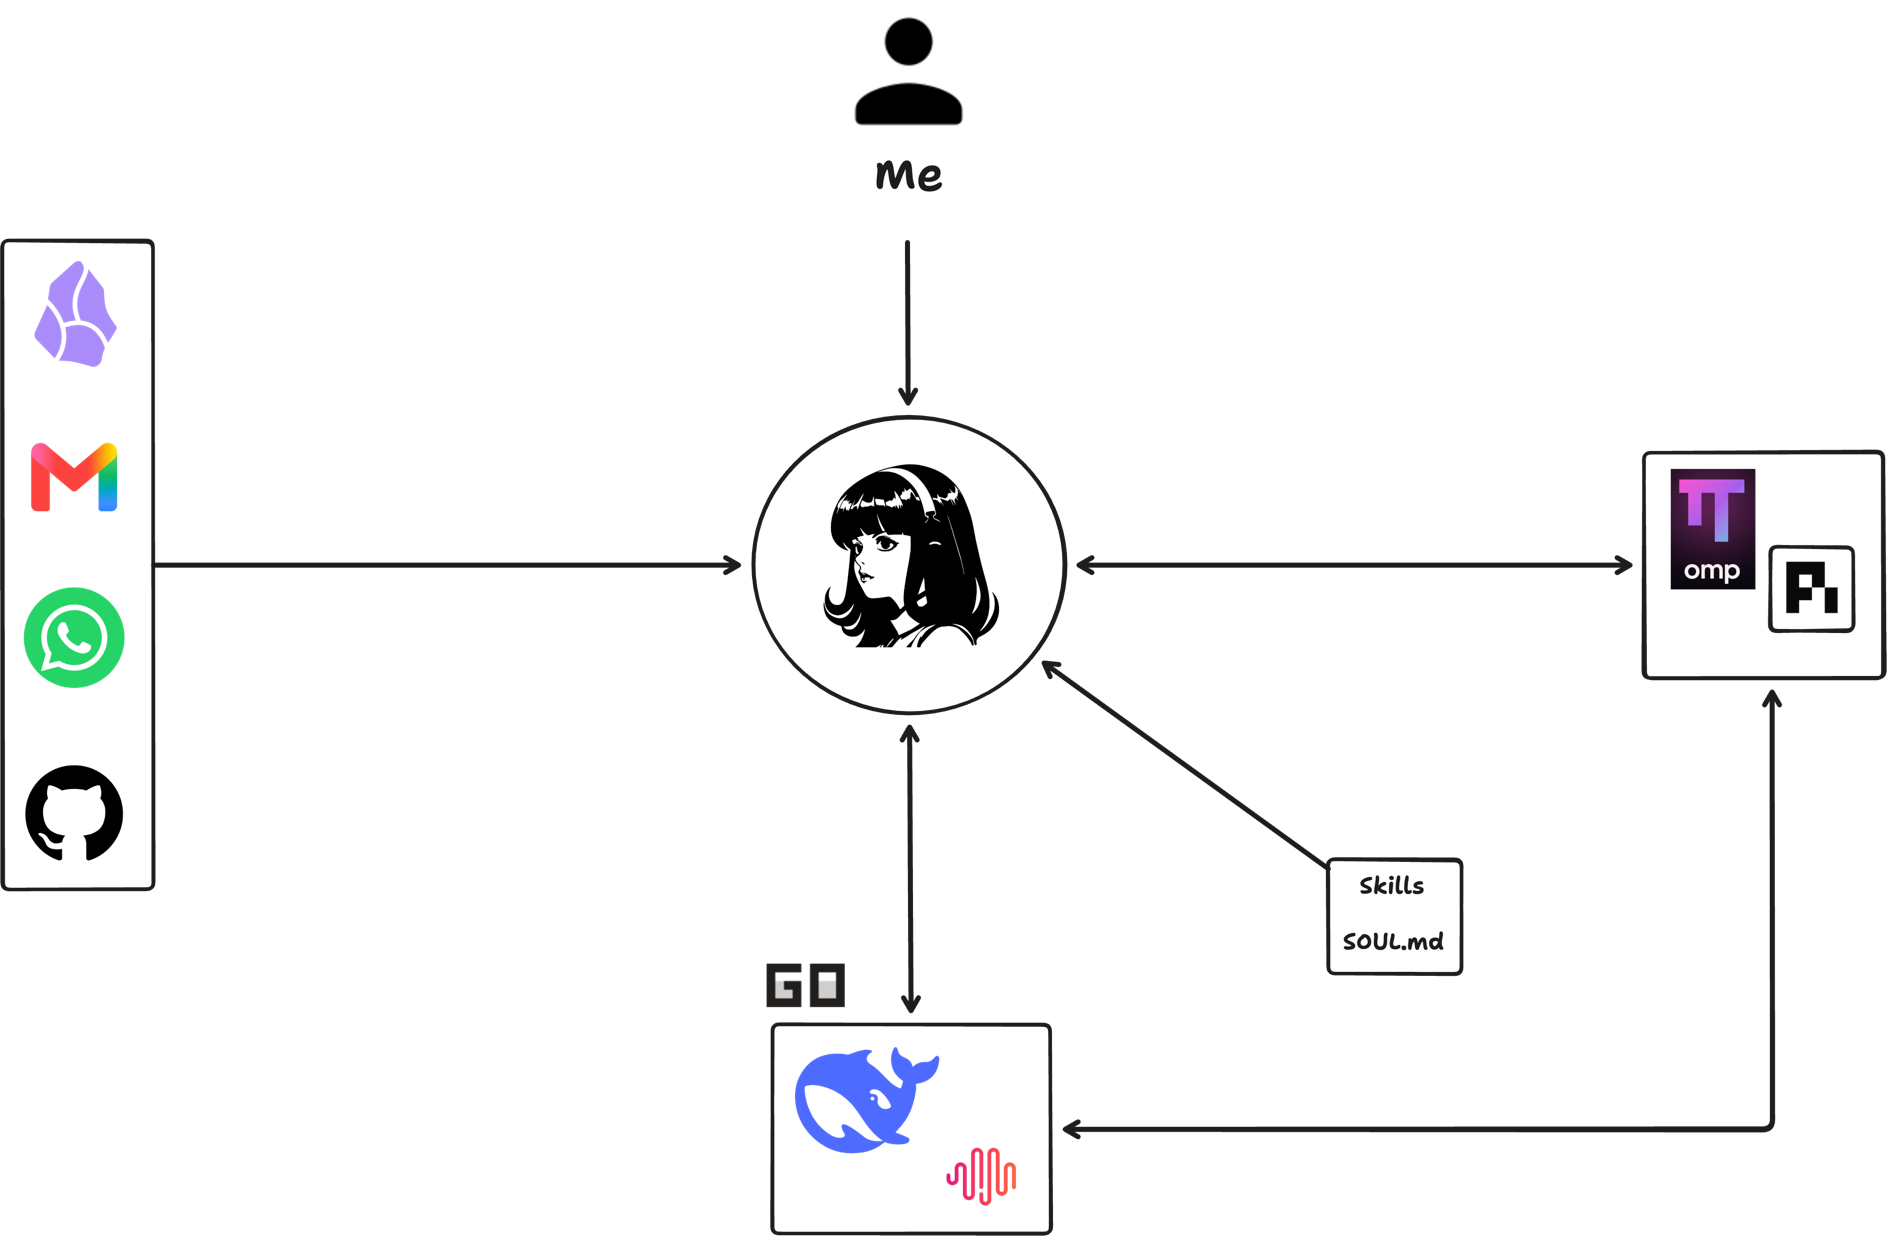
Antes de pasar a los detalles, quiero dar una visión general de mi stack ahora mismo. Las fuentes de información o base de conocimiento consisten en: Obsidian, Gmail, Whatsapp y GitHub, de vez en cuando hay alguna más pero estas son las principales. En Obsidian guardo todos los archivos markdown como SOPs (Standard Operations Procedure), actas de reuniones, investigaciones, posts de X, herramientas, artículos y un largo etcétera, esto por sí solo merece un post aparte. Luego Gmail y Whatsapp, para comunicaciones con clientes y por supuesto GitHub, frecuentemente con GitHub projects, para organizar el desarrollo, trackear las issues, los features y tener el historial de los cambios.
Los modelos
Todo esto está conectado a Hermes (y cualquier herramienta adicional que pueda usar puntualmente). Hasta hace una semana mis sesiones de trabajo con Hermes utilizaban normalmente un modelo potente, este mes fue GPT 5.6 con un thinking extra high, pero desde la salida del último Deepseek V4 Flash, me he dado cuenta de que es un modelo lo suficientemente potente para correr tareas de código de largo horizonte, de forma autónoma y orquestar sesiones de implementación, validar, testear y desplegar. Es todo lo que estaba consiguiendo con GPT 5.6 en mi stack solo que aproximadamente 80 veces más barato (!!!), lo cual es una monstruosidad. De forma que desde hace poco más de una semana estoy usando los modelos de deepseek para todas las tareas, excepto para visión, ahí estoy usando Minimax M3 pues deepseek no es un modelo multimodal. A fecha de hoy, 14 de agosto, cuando estoy escribiendo esto, acaba de salir GLM 5.3, un modelo que compite directamente con Fable y GPT 5.6 y otra vez a una fracción del coste, de forma que sin duda lo estaré incorporando también en mi workflow (posiblemente junto con Kimi k3).
Aparte de la inteligencia, Deepseek tiene un throughput (tokens por segundo) casi 2 veces más rápido de GPT 5.6, de forma que he notado también una mejora en la velocidad de las tareas, tanto de orquestación como de implementación.
Y por supuesto como he dicho, los costes son probablemente lo más llamativo de todo, es simplemente ridículo la cantidad de ahorro. De todas formas, yo no uso la API de los modelos directamente, si no que para los modelos open-source estoy usando el plan de Opencode Go, súper recomendado para tener acceso en una sola suscripción a todos los modelos open-source, además hosteados en EEUU, UE y Singapur.
El orquestador
Desde Hermes, toda esta base de conocimiento se usa para analizar lo que hay sobre la mesa, plantear la arquitectura, planear la implementación, estructurar el trabajo, crear los tickets, validar, investigar (tanto en fuentes propias como en la web) y como paso final preparar los prompts ya sea para otra sesión orquestadora como para sesiones de implementación.
Esto último es importante y ahí está el cambio más significativo en mi flujo de trabajo en los últimos meses: ya no prompteo a los agentes de código. Durante los últimos meses han surgido muchos “agent harness” y skills (o estrategias de prompting se podrían llamar) como ultrawork, drill-me, etc. Llega un momento en el que, si elegir las skills a usar o la forma/estructura de promptear depende de un humano se vuelve tedioso, lento y poco preciso, pues para una sesión de trabajo exitosa el prompt debe ser extenso, claro y acotado.
Aquí entra la magia del Hermes Agent, tras haber revisado las fuentes de información, este cuenta con suficiente contexto como para discutir conmigo qué problemas debemos atajar, en qué orden y con qué prioridad. Probablemente el mayor valor de mi Hermes Agent no está en la propia herramienta (hermes) si no en las skills, las metodologías de trabajo y el SOUL.md. Para tareas de código uso siempre unas 5 skills, con las adicionales que requiera el caso (frontend, Rust, testing), entre 5 y 10. En estas 5 skills principales está anotado el manual de mi forma de trabajar, la forma de orquestar, la forma de hacer testing, la forma de hacer QA y otras tantas tareas que puedan surgir a lo largo de una sesión de trabajo.
Estas skills no se crearon de la noche a la mañana, son skills que han pasado por un largo proceso de iteración y que siguen evolucionando usando metodologías como GEPA, aunque, otra vez, esto requeriría un artículo por sí solo.
La implementación
Hasta hace nada Codex era la herramienta principal de implementación, con los modelos gpt 5.6 sol y luna junto con un plugin construido sobre OmO llamado LazyCodex, que básicamente lleva la misma metodología de OmO a Codex.
Respecto a Claude Code, nunca lo he usado, siempre he usado los modelos de Anthropic desde opencode y OmO hasta la prohibición de Anthropic a usar su suscripción de código en herramientas de terceros.
Entonces, qué uso hoy en día? Pues oh-my-pi (OMP), un harness construido sobre Pi, el cual es increíble, pues no solo aumenta el porcentaje de éxito de las tareas, si no que encima lo consigue con un consumo de tokens reducido, por tanto reduciendo el coste!
OMP también cuenta con muchas funcionalidades muy interesantes que lo hacen destacar entre los demás harnesses, como por ejemplo: modo goal, LSP, subagentes, un modelo asesor mirando la sesión para evitar desviaciones, hashline, memoria y mucho más.
Estas sesiones de OMP son lanzadas por Hermes (en modo headless) en lo que se llaman lanes, es decir, olas de trabajo donde se lanzan varias sesiones paralelas, lo que permite acelerar mucho el ritmo de implementación. También uso herramientas como codegraph que reducen aún más el uso de tokens y aumentan el porcentaje de éxito.
Aún así, viendo el recientemente publicado deepseek harness, sin duda lo voy a estar probando estos próximos días.
La conclusión
Es difícil ponerle un nombre concreto a este sistema, la gente lo empezó a llamar en junio “Loop Engineering”, pero esto parece que está cayendo en desuso o está ambiguo, hay otros que simplemente lo llamarían harness. Al final la etiqueta es lo de menos, es un mundo que cambia y evoluciona tan rápido (literalmente en semanas) que las etiquetas no llegan a tiempo.
Ningún flujo de trabajo es perfecto, siempre hay margen de mejora y errores, todo el rato identifico cosas a cambiar, es un sistema en constante evolución y progreso.
Acompañando a esto, hay una nueva corriente que ha ganado popularidad los últimos meses es el tema de los agentes self-improving. Parte de la popularidad de Hermes, sobre todo al principio, viene de que es capaz de ir actualizando las skills por sí solo. Esto está genial, pero hay veces que ni esto ni la memoria es suficiente. Ahí es donde entran metodologías como GEPA y paradigmas como los Recursive Language Models (RLM), algo muy innovador y que seguro vamos a ir escuchando cada vez más en los próximos meses.
El cierre
Seguramente en unos meses (o semanas, quién sabe) vuelva a hacer un post sobre esto, me emociona pensar cómo habrá cambiado mi flujo de trabajo para entonces. Aunque hay ciertas cosas que son predecibles, hay otras muchas que son totalmente inesperadas.
Al final del día, en este mundo lo importante es estar constantemente al día, no tener miedo de probar cosas nuevas, y sobre todo, no casarte con ninguna herramienta y no tener miedo a dejarla atrás si es necesario.